0822
2026년 8월 22일
카테고리 : 벌칸, 멀티스레딩
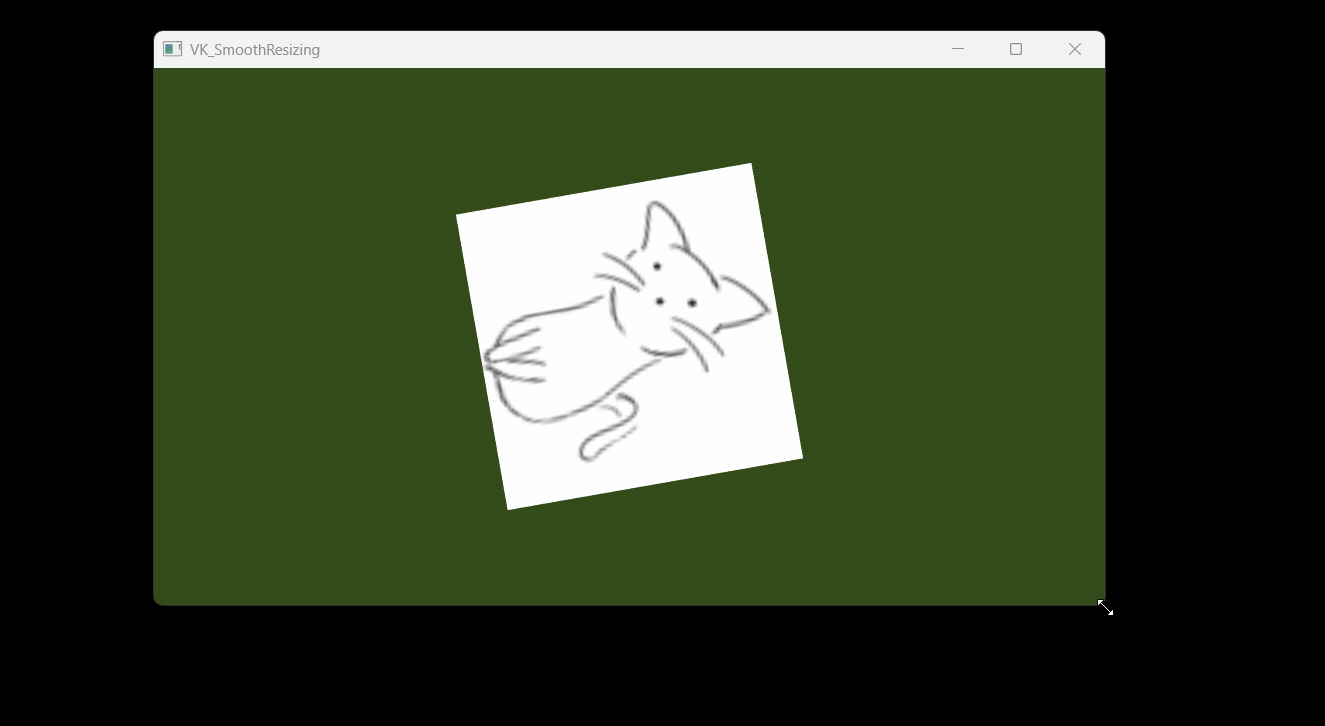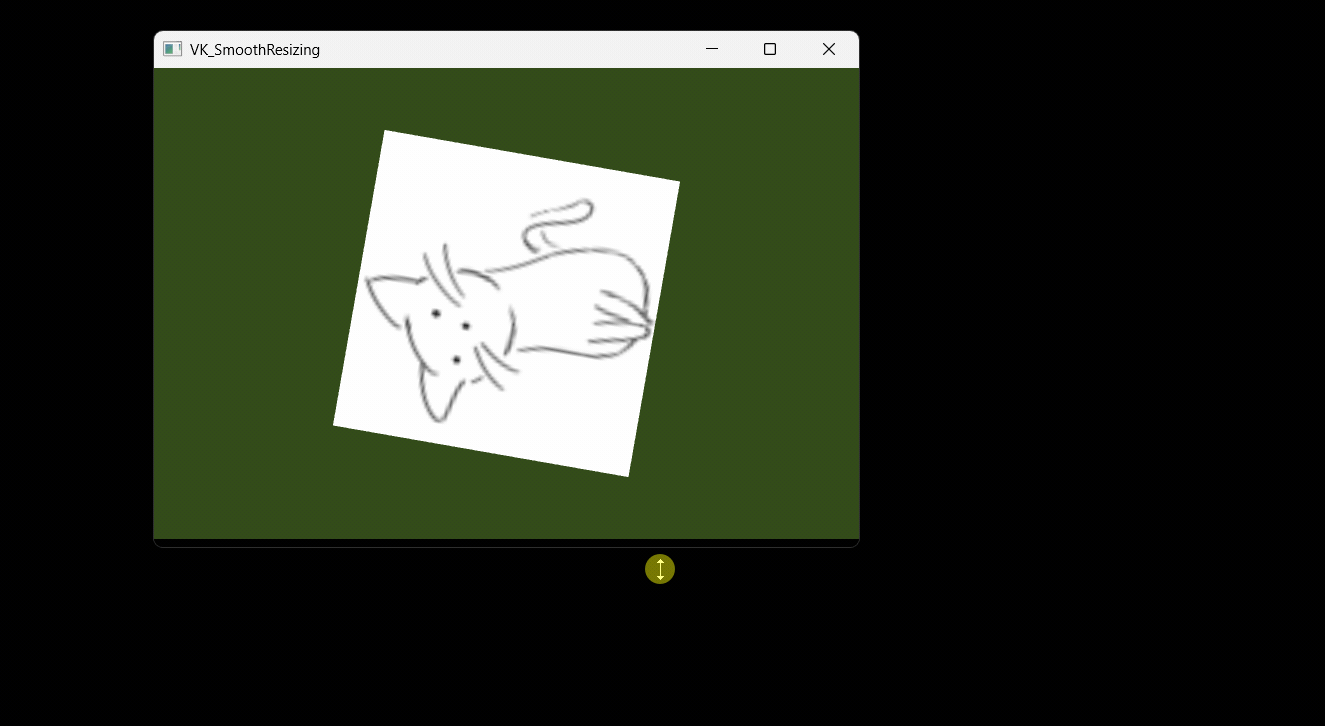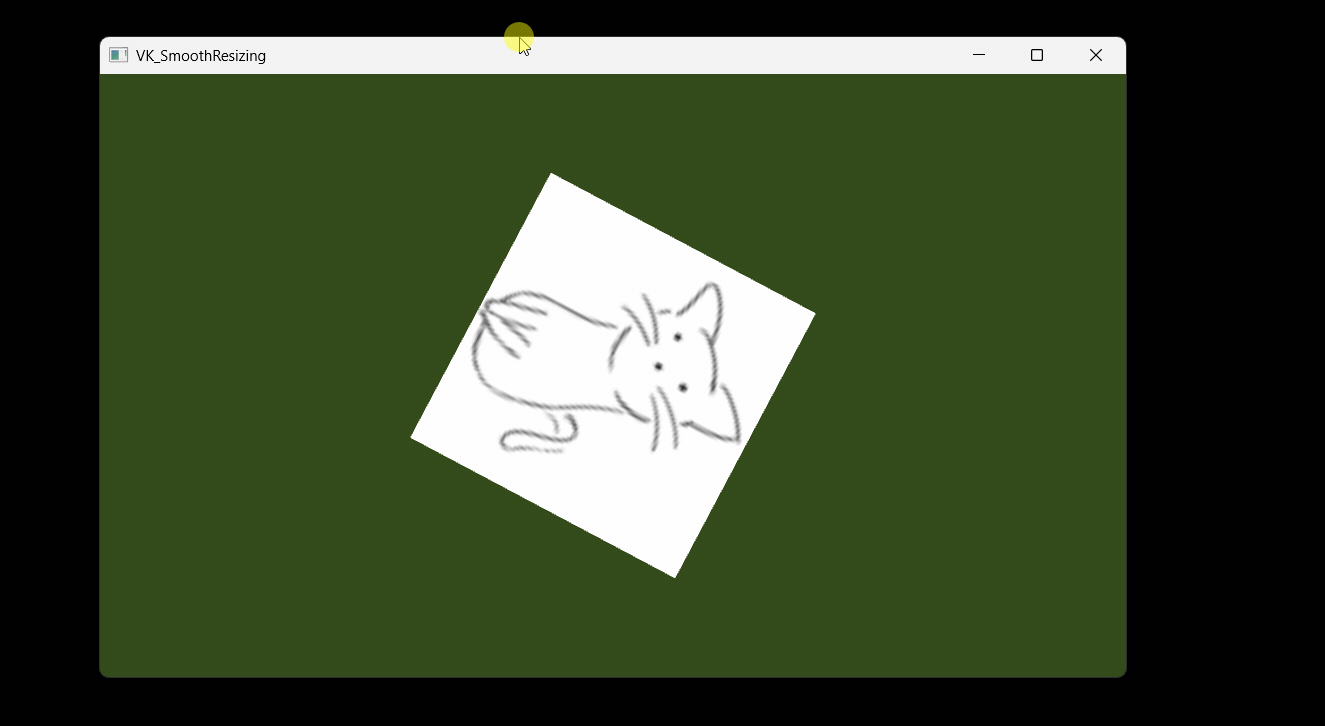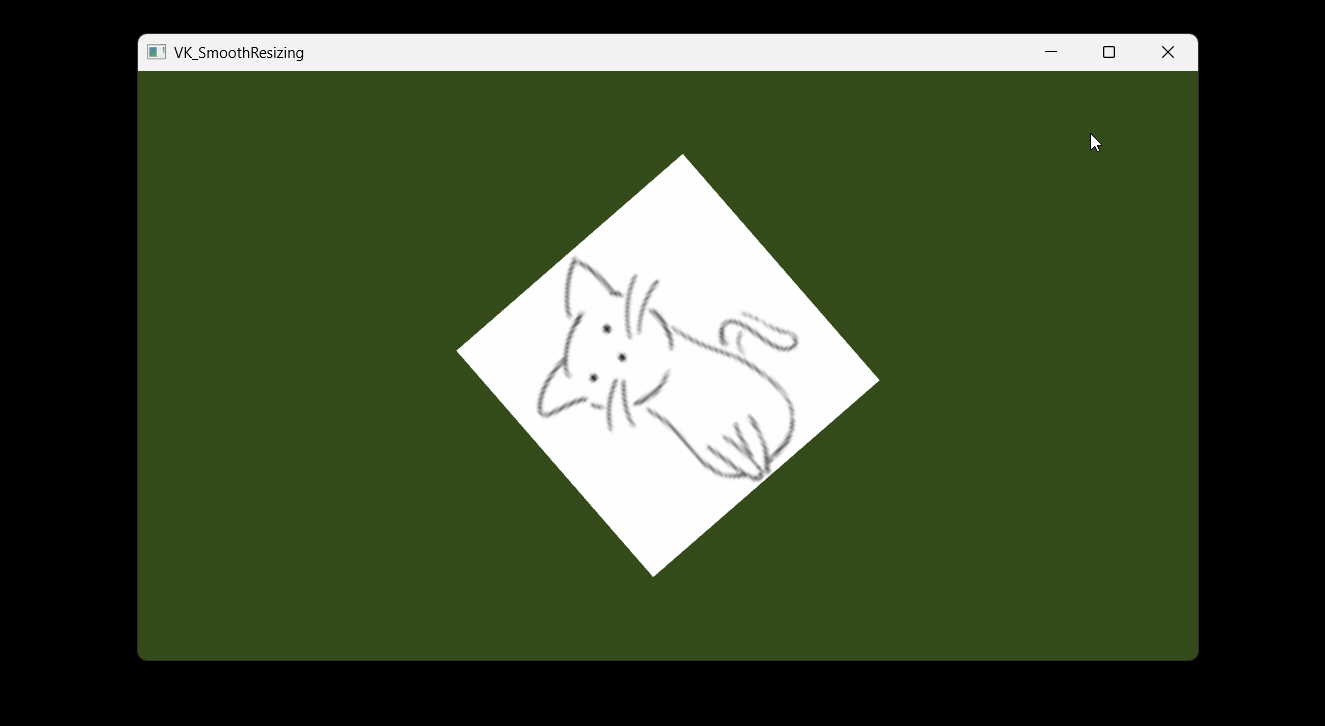
GL_SmoothResizing 을 벌칸으로 대응시켜보았다.
Daxa 만으로는 내부구조가 안 맞아서
핸들 추출한 후에
원시 vulkan.h 헤더를 가져와서
붙여주었다.
GL에서는 뮤텍스와 lock_guard + cv 조합을 썼었지만
C++ 20사양 덕분에
std::atomic<> 만으로도 구현이 가능하단 걸 알게되었다.
결국에 콘셉트는 GL버전과 완전히 동일하다.
- 메인 스레드에서, 창 크기가 변한 경우? '한 프레임이 완전히 다시 그려질 때까지 대기해야 한다'
이 조건을 만족시키기 위해서
메인스레드에서는
- std::atomic<>::wait(T Expected) 로, 내부값이 Expected 이 아니게 될 경우 깨어나도록 하기
렌더스레드에서는
- std::atomic<>::fetch_add(T Val) 로 값 변경
- std::atomic<>::notify_all(); 로 (만약 메인스레드가 자고 있었다면) 깨우기
이러한 구조를 사용하였다.
벌칸으로 올리면서 약간 달라진 게 있다면
스왑체인과 오프스크린 이미지(옵션)를
리사이징 시 다시 만들어줘야 한다는 것이다.
처음에 daxa로 이걸 구현하다가
창 리사이징 중에, 매 프레임마다 스왑체인 reset 이 너무나 무거웠다.
(0.07초가 걸렸다..)
왜인지는 모르겠는데, daxa 추상화에서는
typedef struct VkSwapchainCreateInfoKHR {
    VkStructureType                  sType;
    const void*                      pNext;
    VkSwapchainCreateFlagsKHR        flags;
    VkSurfaceKHR                     surface;
    uint32_t                         minImageCount;
    VkFormat                         imageFormat;
    VkColorSpaceKHR                  imageColorSpace;
    VkExtent2D                       imageExtent;
    uint32_t                         imageArrayLayers;
    VkImageUsageFlags                imageUsage;
    VkSharingMode                    imageSharingMode;
    uint32_t                         queueFamilyIndexCount;
    const uint32_t*                  pQueueFamilyIndices;
    VkSurfaceTransformFlagBitsKHR    preTransform;
    VkCompositeAlphaFlagBitsKHR      compositeAlpha;
    VkPresentModeKHR                 presentMode;
    VkBool32                         clipped;
    VkSwapchainKHR                   oldSwapchain;
} VkSwapchainCreateInfoKHR;
위에서 oldSwapchain 을 사용하지 않는 것 같았다.
저걸 써 줘야만 메모리 재사용하고
다시 만들 때 딜레이가 줄어든단다.
(사실 공개된 벌칸 코드를 보면 '렌더링 부분' 을 여러 스레드로 나눠놓은 것,
즉 Task(=Render) Graph 구현은 많지만
메인입력스레드와 렌더 스레드를 나눠놓고
창이 리사이징 될 때에도 렌더링이 멈추지 않게 하는 데모는
단 한 개도 못 봤다.
아마 daxa개발자도 이것까지 고려하진 않았던 듯 하다.
Chromium이나 고도 엔진 같은 것도
백엔드는 벌칸이지만, 뜯어볼 엄두가 안 났다.)
요약하자면,
daxa로는 버퍼, 이미지, 샘플러, 파이프라인 (+매니저) 클래스를 써서
실질적인 커맨드 버퍼를 채우는 부분.
즉 daxa::CommandRecorder 를 활용했다.
(아마 자원 초기화랑 렌더커맨드 기록하는 부분이
daxa같은 추상화 인터페이스가 절실한 곳일 거다.
특히 desc set 부분은 daxa가 매우 완벽하게 추상화한다)
나머지, 내 의도대로 만들기 위해서
instance, device, queue 같은 건 daxa에서 추출하고
swapchain은 직접 만든다.
중요한 건,
오프스크린 이미지를 하나 만들어 둔 다음에
daxa명령으로 그 이미지에 전부 그린다음
이미지를 (내가 만든) 스왑체인 이미지에다가
blit 해주는 거다.
그러면 충돌 안 나고
잘 작동한다.